 26/09/20(日)23:33:55No.1470350774+
00:57頃消えます
まさかOCRの話できると思えてなかったのでびっくりしたこのスレは古いので、もうすぐ消えます。
自分はOCRで自炊した本とかじゃなくて今まで作った書類とかもらったメモとかを全部電子化しててOCR導入してた
PaddleOCRとTesseractを入れてたんだけどマジでエラー多くて全然使い物にならなくて開発ストップしてた
| … | 126/09/20(日)23:34:53No.1470351100+それでさっきのスレの「」との会話でもう一回練ってみるかと思って相談してたんだけど導入したOCRが古いバージョンだったことがわかった |
| … | 226/09/20(日)23:36:37No.1470351700+全部AIで読み込めば簡単なんだけど中にはパスワードだったり住所だったりがあるからオンラインで読み込むのもなってのがあってOCRを使ってるんだよね |
| … | 326/09/20(日)23:38:30No.1470352444+ndlocr_liteを自分で使ったりAIに使わせてるけど日本語文献なら特に支障なく使えるな |
| … | 426/09/20(日)23:39:57No.1470353023+>ndlocr_liteを自分で使ったりAIに使わせてるけど日本語文献なら特に支障なく使えるな |
| … | 526/09/20(日)23:40:22No.1470353217+ドラマCDを文字起こしならGeminiの精度が良かったな |
| … | 626/09/20(日)23:41:59No.1470353848+>ドラマCDを文字起こしならGeminiの精度が良かったな |
| … | 726/09/20(日)23:42:20No.1470353987+調査もうちょっとしたらわかったと思うけど国立国会図書館のはliteは精度ちょっと低いしそもそも古い縦書き文献読むようだから現代の文書に向いてない |
| … | 826/09/20(日)23:43:02No.1470354276+ローカルでもAIOCR出来るんかな |
| … | 926/09/20(日)23:44:09No.1470354718+OCRはGoogleが強いと聞く |
| … | 1026/09/20(日)23:45:37No.1470355243+昔はPDFは読めにゃい!されたのに立派になったのぉ… |
| … | 1126/09/20(日)23:45:39No.1470355249+>ローカルでもAIOCR出来るんかな |
| … | 1226/09/20(日)23:46:05No.1470355410そうだねx1>昔はPDFは読めにゃい!されたのに立派になったのぉ… |
| … | 1326/09/20(日)23:46:33No.1470355573+opencvで前処理する適切に文字のある場所判定させる判定した箇所適切にクロップして順番崩さないようにするをLLMは勝手にやってくれるからローカルは自分で設定しないと精度上がらない |
| … | 1426/09/20(日)23:47:31No.1470355902+動画からPDF作ってくれるしもう普通に読めてんじゃね |
| … | 1526/09/20(日)23:48:27No.1470356231+>yomitokuとかで検知方法とか分割して解析させるようにすると精度上げられるよ |
| … | 1626/09/20(日)23:51:15No.1470357204+>それでさっきのスレの「」との会話でもう一回練ってみるかと思って相談してたんだけど導入したOCRが古いバージョンだったことがわかった |
| … | 1726/09/20(日)23:52:50No.1470357764+まずは2026年現在のローカルで使える日本語OCR事情調査させるといいよ |
| … | 1826/09/20(日)23:52:52No.1470357772そうだねx1筑波のあたりのけしからんの人がYomiToku入りのスキャンPDFをいじいじするのgithubにあげてた気がする |
| … | 1926/09/20(日)23:53:06No.1470357878+今はWindowsにも標準で入ってるよね |
| … | 2026/09/20(日)23:53:35No.1470358065+>マジーーー……? |
| … | 2126/09/20(日)23:56:35No.1470359171+こんな深夜から実装したくなるの楽しいわぁ |
| … | 2226/09/20(日)23:56:48No.1470359248+休み最高だね |
| … | 2326/09/20(日)23:57:29No.1470359506+>エンジンパッケージ役割 |
| … | 2426/09/20(日)23:58:52No.1470359958+>ありがとう |
| … | 2526/09/20(日)23:59:00No.1470360004+pro20でも足りない!! |
| … | 2626/09/21(月)00:02:27No.1470361448+paddleはゲーム画面用途だと良さそうだけどdetectorだけ使って日本語専用モデル入れた方がいいよって言われる |
| … | 2726/09/21(月)00:02:47No.1470361579+数ヶ月前から自炊したPDFを数十冊くらいOCRでテキスト化する作業してたんだけど解像度低い状態でやってたみたいでAstraが300DPIくらいでやり直しますねって言ってやり直してくれたらボロボロ誤字脱字の指摘が出てくるわ |
| … | 2826/09/21(月)00:03:00No.1470361645+スマホから初めてcodex操作してるけど意外とやれるもんだな |
| … | 2926/09/21(月)00:03:49No.1470361963+>いやこのバージョンはゴミだったバージョンだよ |
| … | 3026/09/21(月)00:05:03No.1470362509+画像生成の効率化について聞いてみたらプロジェクトの活用を提案されたんだけど |
| … | 3126/09/21(月)00:05:50No.1470362858+OCR技術が一段階上がるとまじで助かるな |
| … | 3226/09/21(月)00:06:15No.1470363032そうだねx1メモリ参照具合が変わってるんじゃない? |
| … | 3326/09/21(月)00:06:43No.1470363221+ゴミソフトのバージョンを紹介してぬか喜びさせてしまってすまない… |
| … | 3426/09/21(月)00:06:50No.1470363272+fu7292937.jpg |
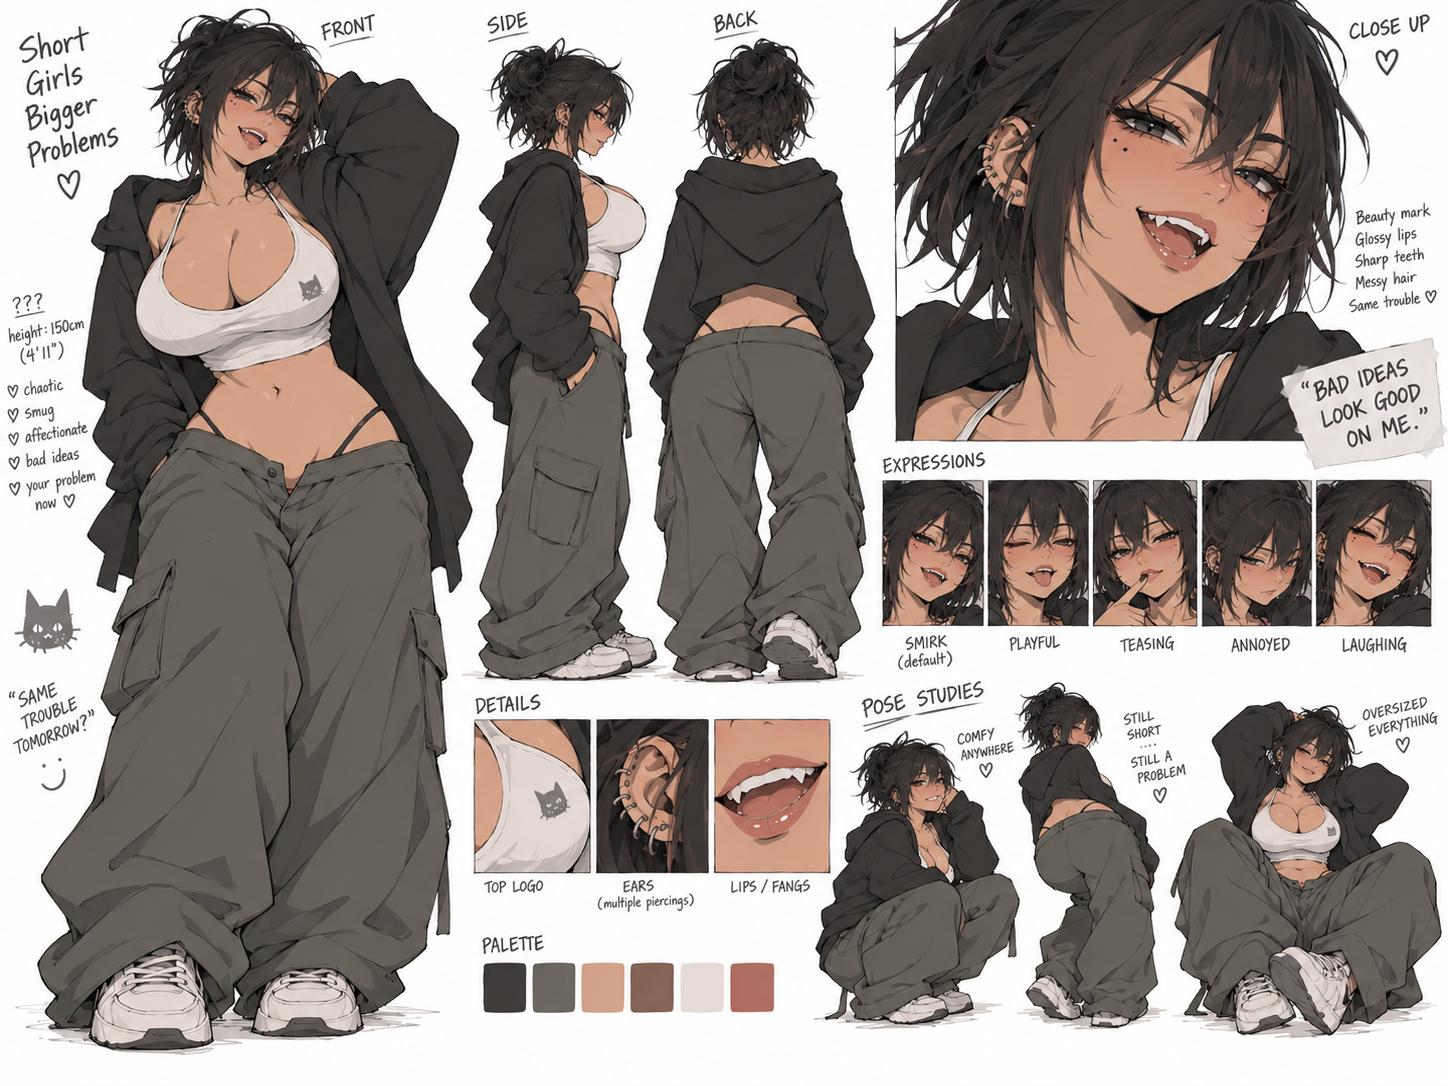
| … | 3526/09/21(月)00:07:37No.1470363606+漫画のキャラクターを読み解かせるために漫画のセリフを誰のセリフか込みで文字に起こしたい |
| … | 3626/09/21(月)00:07:53No.1470363742+>ゴミソフトのバージョンを紹介してぬか喜びさせてしまってすまない… |
| … | 3726/09/21(月)00:08:04No.1470363848+スレッドを立てた人によって削除されました |
| … | 3826/09/21(月)00:08:23No.1470364005そうだねx2LLMのOCRが従来のOCRと比べて精度高いのは当然だけどもうちょっと何とかならないかと思うよね |
| … | 3926/09/21(月)00:08:50No.1470364228+>OCRはGoogleが強いと聞く |
| … | 4026/09/21(月)00:08:55No.1470364259+>パッケージOCRより圧倒的にチャッピーの精度が高すぎるのが腹立つ… |
| … | 4126/09/21(月)00:09:05No.1470364340+>ゴミソフトのバージョンを紹介してぬか喜びさせてしまってすまない… |
| … | 4226/09/21(月)00:09:26No.1470364478+>LLMのOCRが従来のOCRと比べて精度高いのは当然だけどもうちょっと何とかならないかと思うよね |
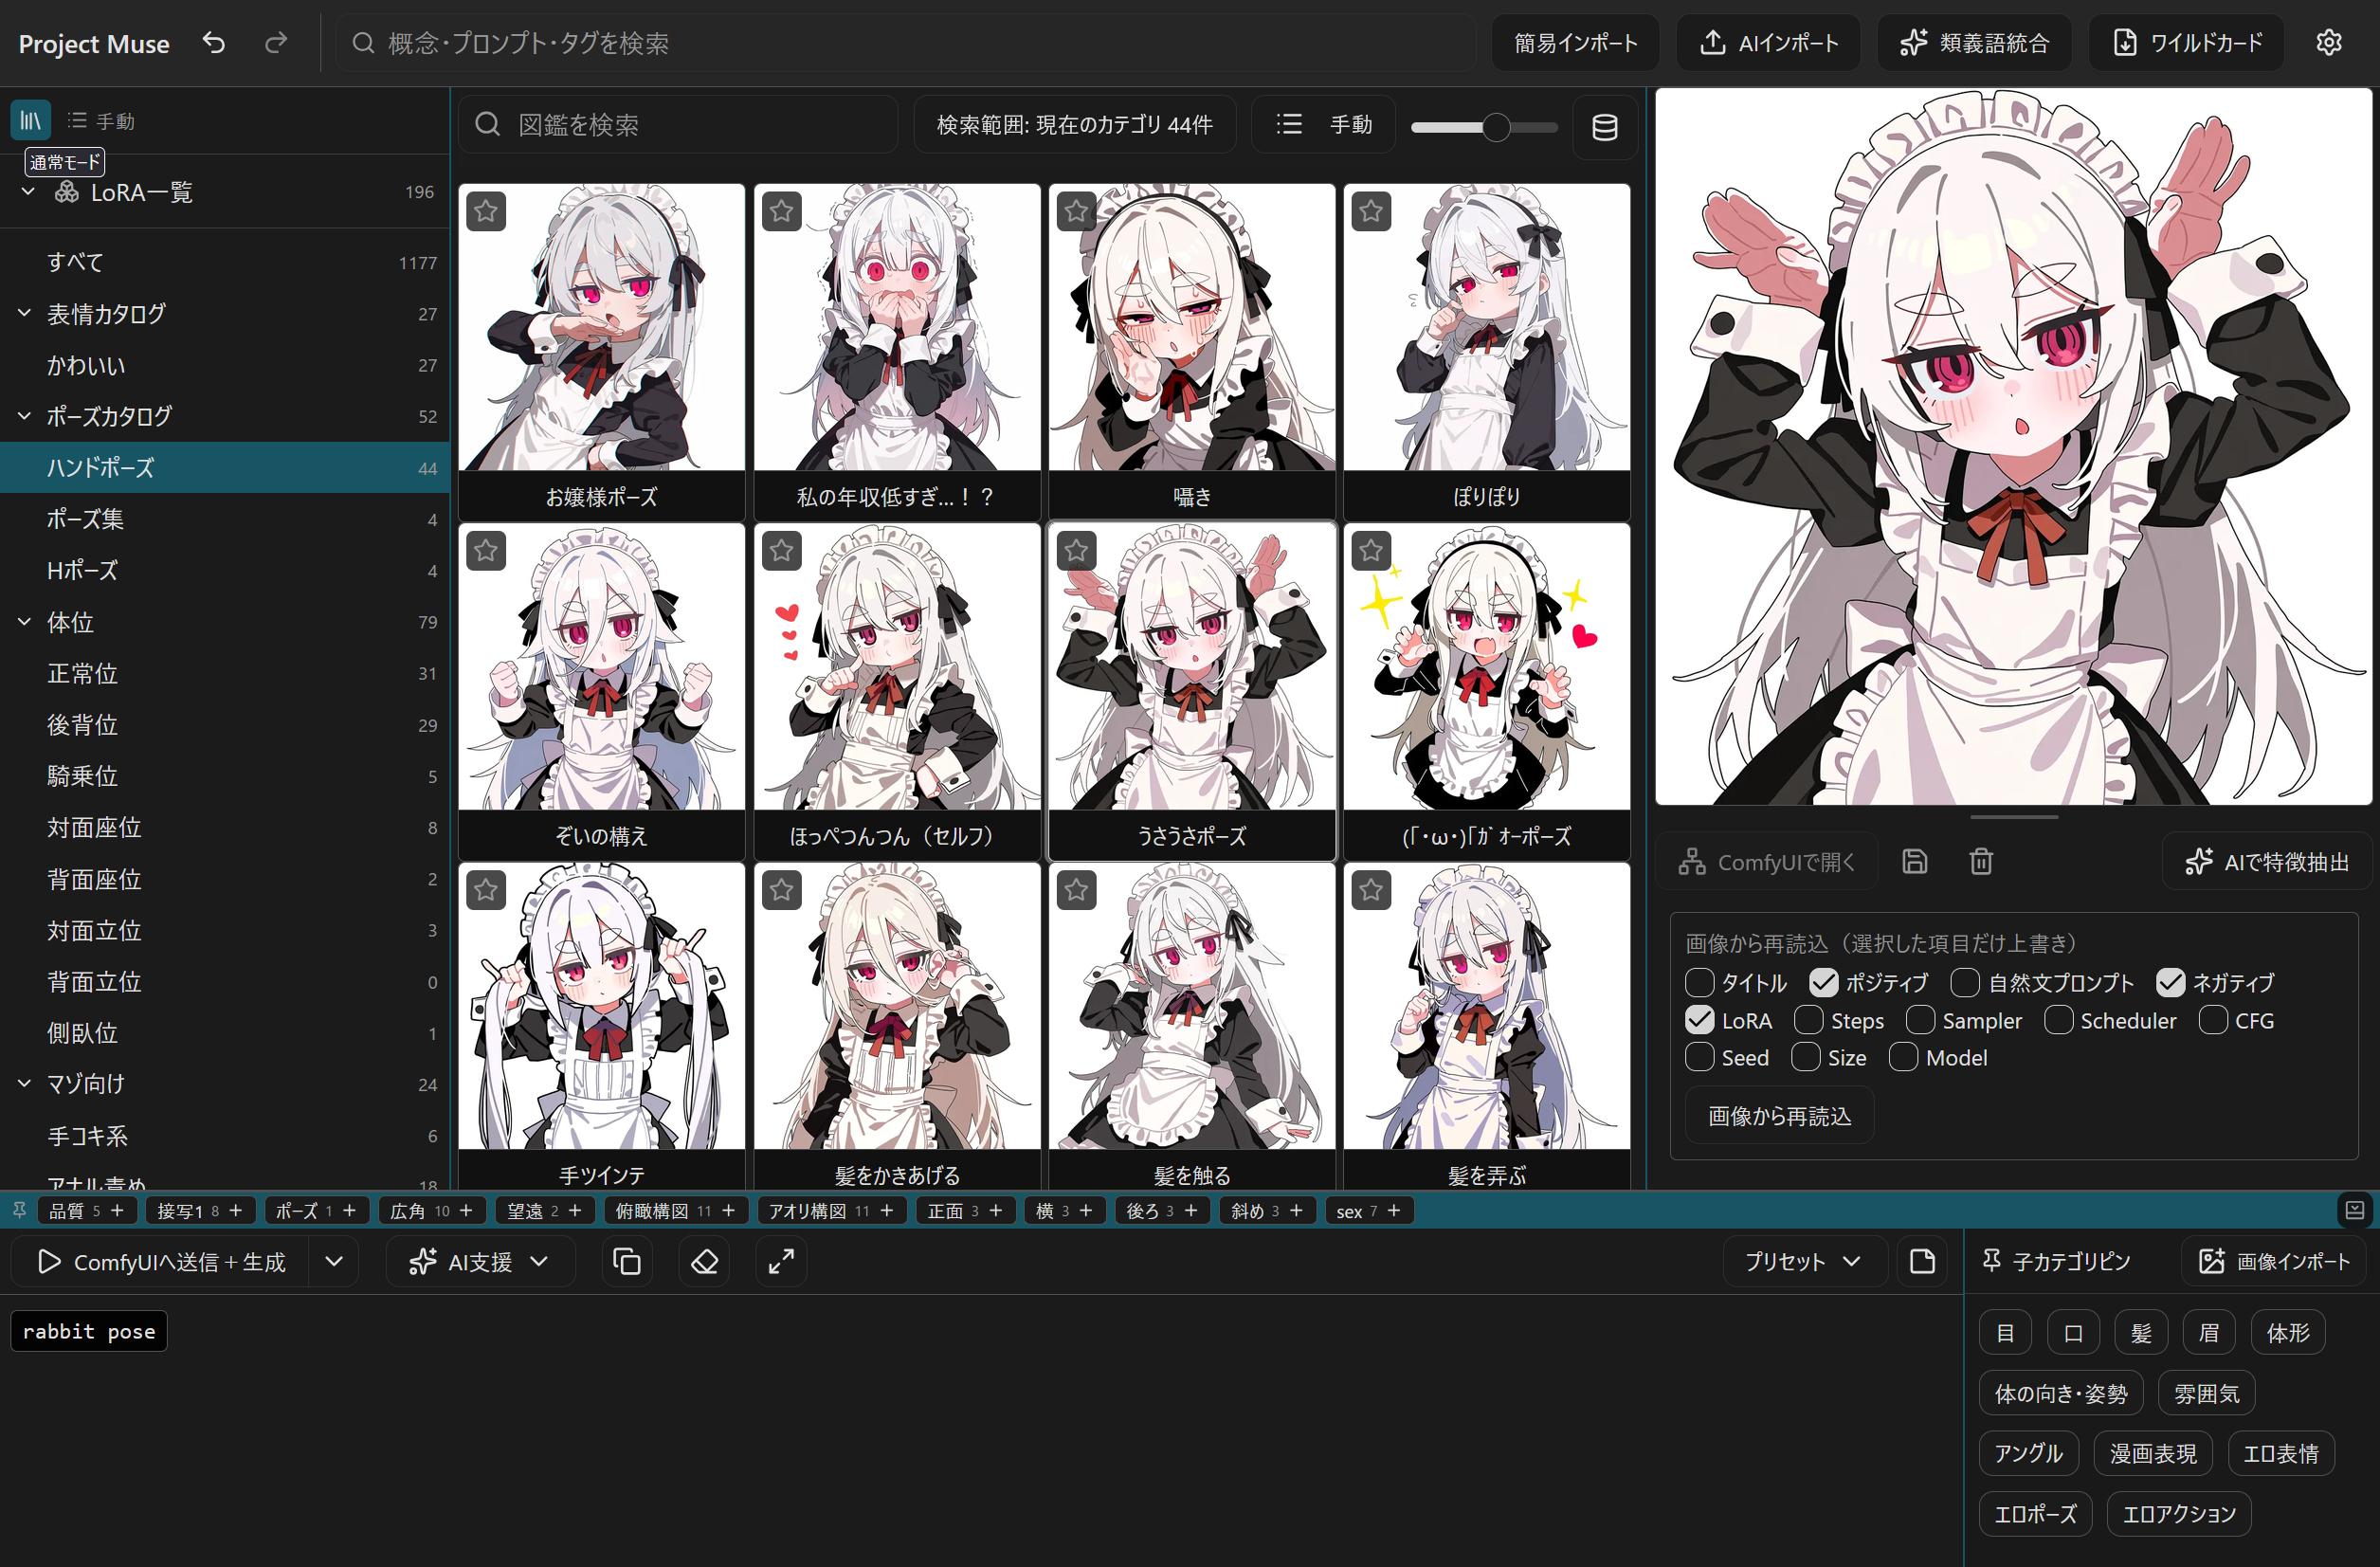
| … | 4326/09/21(月)00:09:29No.1470364491+チャッピーに画像生成用のプロンプト語句辞典ツール作らせてるけどR18系も普通に収集してくれてありがとうって気持ち |
| … | 4426/09/21(月)00:10:19No.1470364825そうだねx1車輪の再開発するより既存の優秀なやつで良くねってなっちゃうな |
| … | 4526/09/21(月)00:11:21 ID:VYxuF0cANo.1470365301+書き込みをした人によって削除されました |
| … | 4626/09/21(月)00:15:40No.1470367171そうだねx2プロンプトは画像付きがわかりやすいからどこぞのサイトブクマしてる方が楽だったりする |
| … | 4726/09/21(月)00:16:12No.1470367339+小説漫画ゲーム画面の6輪車みたいなのがないから車輪整備してるよ |
| … | 4826/09/21(月)00:17:51No.1470367956そうだねx1OCRのソフト開発するとファイルサイズがでかくなるのだけがネックだ |
| … | 4926/09/21(月)00:18:10No.1470368068+>プロンプトは画像付きがわかりやすいからどこぞのサイトブクマしてる方が楽だったりする |
| … | 5026/09/21(月)00:18:22No.1470368142+>小説漫画ゲーム画面の6輪車みたいなのがないから車輪整備してるよ |
| … | 5126/09/21(月)00:21:19No.1470369209+プロンプトといえば俺は画像ビューアみたいなの作ったよ |
| … | 5226/09/21(月)00:23:35No.1470370004+俺も最近なってLLMOCRに手を出し始めたけどまじでゴミで頑張ってたころと比べて世界が拓けた感じだ |
| … | 5326/09/21(月)00:24:03No.1470370166+ローカルLLMがもっと軽く動いたらなぁ |
| … | 5426/09/21(月)00:24:28No.1470370318そうだねx5何かを貶さないと何かを評価出来ないのは好まれないぜ |
| … | 5526/09/21(月)00:24:31No.1470370342+>ゴミの開発に携わった人達かわいそうだな |
| … | 5626/09/21(月)00:24:52No.1470370479+fu7293044.jpg |
| … | 5726/09/21(月)00:25:21No.1470370664+>俺も最近なってLLMOCRに手を出し始めたけどまじでゴミで頑張ってたころと比べて世界が拓けた感じだ |
| … | 5826/09/21(月)00:25:22No.1470370671+>fu7293044.jpg |
| … | 5926/09/21(月)00:26:37No.1470371140+>プロンプトは画像付きがわかりやすいからどこぞのサイトブクマしてる方が楽だったりする |
| … | 6026/09/21(月)00:28:18No.1470371704+>すっげぇ!そのキャラも安定してチャッピーで出る? |
| … | 6126/09/21(月)00:29:08No.1470371955+>>すっげぇ!そのキャラも安定してチャッピーで出る? |
| … | 6226/09/21(月)00:29:10No.1470371971+本当に学習されてないか分かったもんじゃないし社内で完結するものは残すでしょ |
| … | 6326/09/21(月)00:29:25No.1470372066+俺が翻訳アプリ作った時のも |
| … | 6426/09/21(月)00:30:08No.1470372305+俺も画像生成あんまりやらんな |
| … | 6526/09/21(月)00:30:54No.1470372583+エロ生成してたら背景生成にちょっとはまってしまった |
| … | 6626/09/21(月)00:31:16No.1470372695+OCR用途ならローカルLLMもそこそも精度高いよ |
| … | 6726/09/21(月)00:31:25No.1470372754+Plusだとchat酷使して色んな実装もやらないとAstra使った後はもう画像生成以外やる事がなくなっていくぜ… |
| … | 6826/09/21(月)00:32:08No.1470372993+>俺が翻訳アプリ作った時のも |
| … | 6926/09/21(月)00:32:38No.1470373149+ちょうど画像生成してるけどちゃんと助走すればモデレーター回避策考えてくれて案外頼りになるじゃんSol軽となってる |
| … | 7026/09/21(月)00:33:00No.1470373275+>OCR用途ならローカルLLMもそこそも精度高いよ |
| … | 7126/09/21(月)00:34:06No.1470373640+>>俺が翻訳アプリ作った時のも |
| … | 7226/09/21(月)00:35:29No.1470374129+スレッドを立てた人によって削除されました |
| … | 7326/09/21(月)00:35:41No.1470374183+けしからん人のプログラムを使っていたんだけどもRTX3080で百科事典 1冊処理するのに24時間ぐらいかかった |
| … | 7426/09/21(月)00:36:06No.1470374330そうだねx2fu7292389.gif |
| … | 7526/09/21(月)00:39:07No.1470375270+ナノバナナ2より8bのモデルの方が強いの震えてる |
| … | 7626/09/21(月)00:39:58No.1470375549+>こっちも言い訳してた |
| … | 7726/09/21(月)00:39:59No.1470375557+ソシャゲで「あのセリフいつ言ったやつだっけ…」って時々なるからストーリー取り込んで記録してえなぁって作ったけど精度に限界があるから |
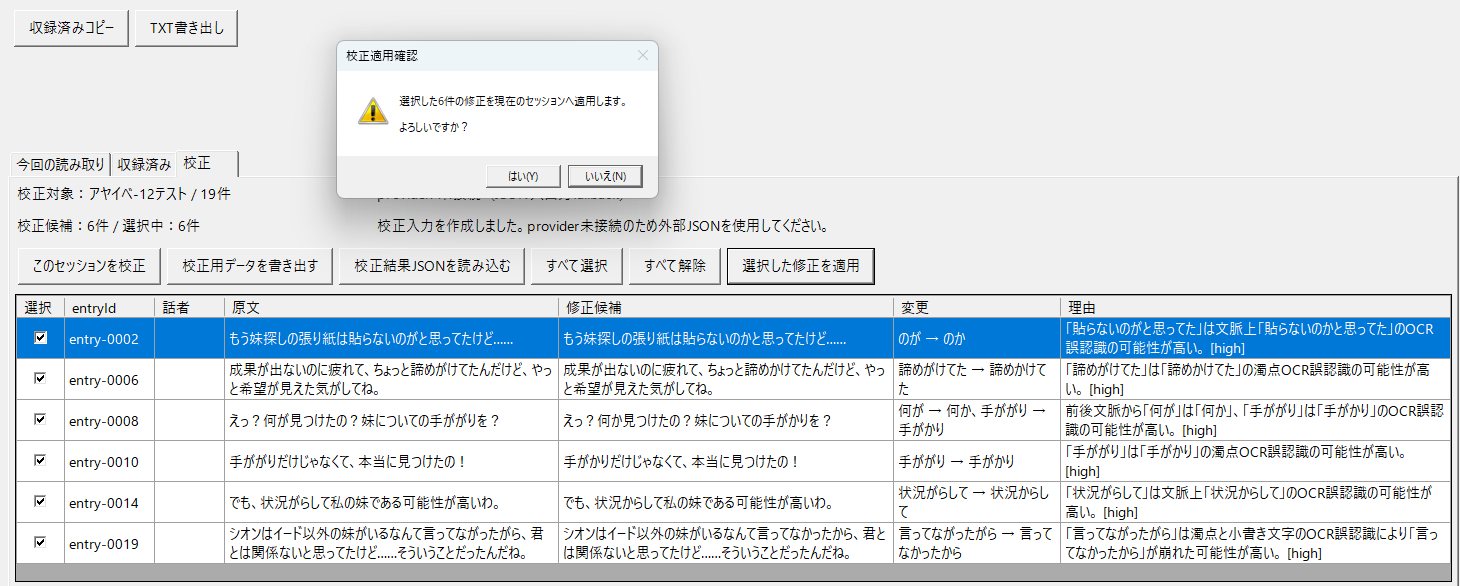
| … | 7826/09/21(月)00:40:42No.1470375752+yomitokuマジでやべーぞ |
| … | 7926/09/21(月)00:40:58No.1470375816+書き込みをした人によって削除されました |
| … | 8026/09/21(月)00:42:12No.1470376210+oneocrがかなり精度良くて速いよ |
| … | 8126/09/21(月)00:46:11No.1470377343+yomitokuメインにしたら180度反転してる文字もちゃんと読めるのかな? |
| … | 8226/09/21(月)00:48:35No.1470378051+なんか入力して送信しても応答帰ってこないんだが |
| … | 8326/09/21(月)00:48:47No.1470378105+わりとまだエラー出てるけど精度すげー上がったわ |
| … | 8426/09/21(月)00:49:55No.1470378456+スレッドを立てた人によって削除されました |
| … | 8526/09/21(月)00:50:26No.1470378577+yomitokuってあんまり知られてなかったんだな |
| … | 8626/09/21(月)00:52:21No.1470379150+yomitoku使ってみたけどいまいちjun文学の読み取り精度が良くなかった⋯ |
| … | 8726/09/21(月)00:52:50No.1470379279+見る度に知らんことを話しててすごいな「」たちは |
| … | 8826/09/21(月)00:52:51No.1470379285+AI OCRはGeminiだと思ってたけど今違うんかな |
| … | 8926/09/21(月)00:54:13No.1470379660+>yomitoku使ってみたけどいまいちjun文学の読み取り精度が良くなかった⋯ |
| … | 9026/09/21(月)00:54:41No.1470379801+ディテクターみんな持ってるものだけどディテクター自前で用意差し替えもできるし調整も効くし前処理でグレスケとか二値化する処理やらせるかでも精度は変わるからアレと違ってと言うには条件揃えないと |